
🔹 記憶體對齊與基礎架構設定
【📌 記憶體對齊】使用posix_memalign配置64位元對齊記憶體,確保向量化運算效能。【⭐ 效能優化】定義宏與內聯函數soft_thresh實現無分支軟閾值運算,降低處理器管線停頓。【📋 巨集設定】啟用Eigen的高效能矩陣運算與迴圈展開選項,減少編譯期除錯開銷。
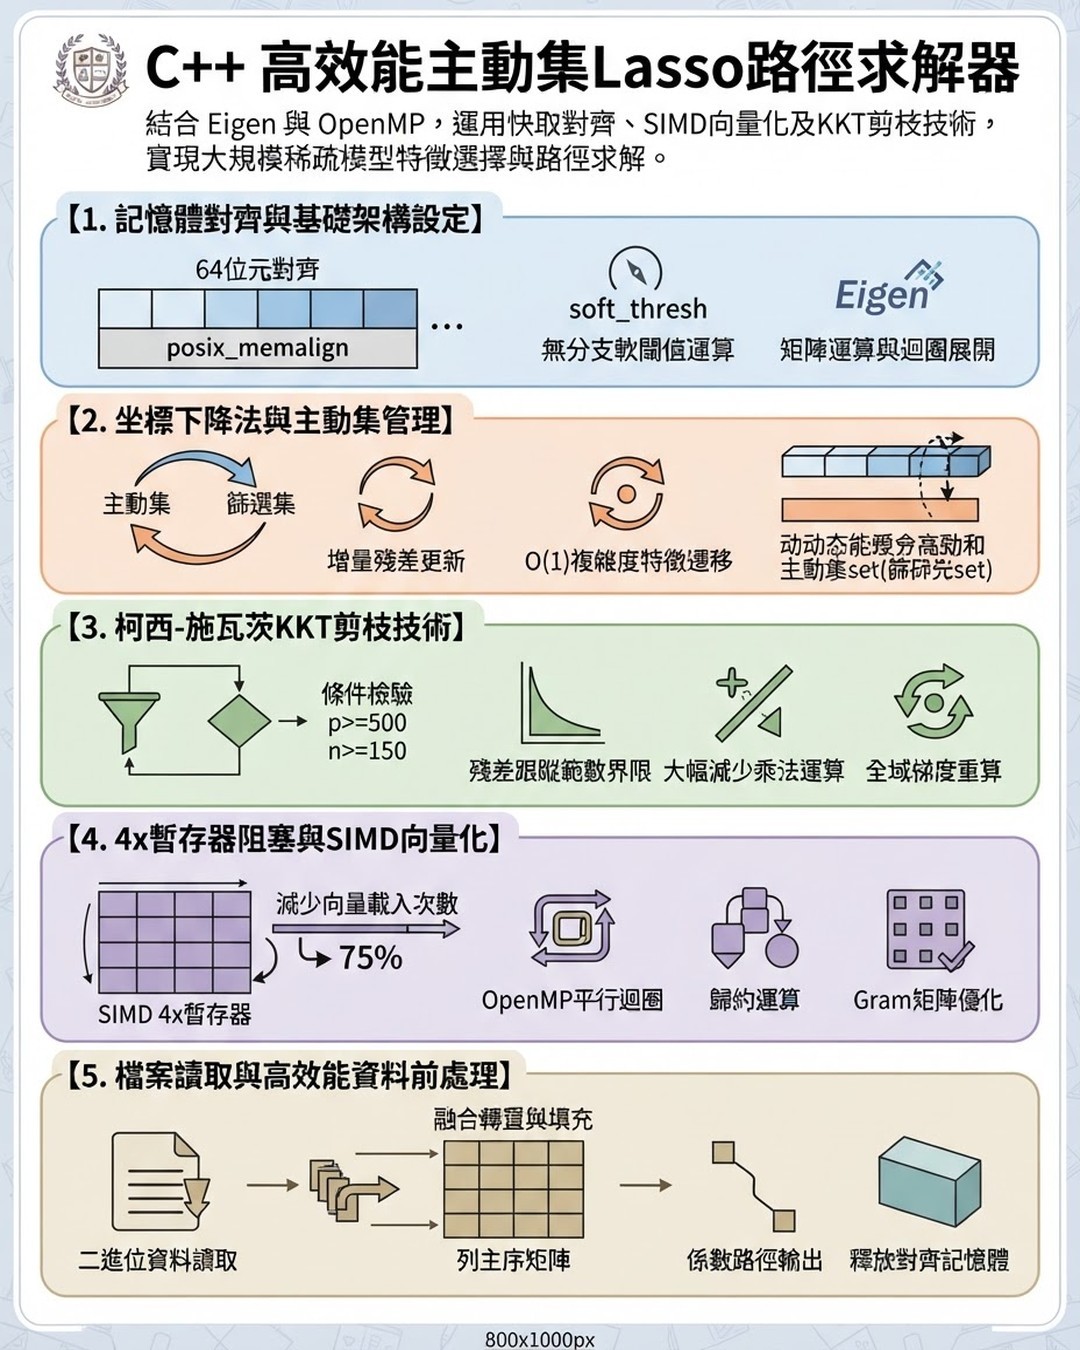
本程式碼實作了一套基於C++的高效能動態主動集Lasso路徑求解器,結合了Eigen線性代數庫與OpenMP平行計算技術。核心演算法透過快取對齊、SIMD向量化運算及柯西-施瓦茨KKT剪枝技術,大幅提升特徵篩選與坐標下降法的執行效率。 系統在資料載入階段採用快取分塊的平行轉置與填充技術,避免重複的記憶體分配開銷。求解過程中利用動態容量調整與不相交分割主動集管理,精確控制記憶體配置並實現O(1)複雜度的特徵遷移。 透過雙階段強規則與全域KKT條件檢驗,配合4x暫存器阻塞優化,程式碼有效降低記憶體頻寬壓力。殘差的增量更新與相關係數矩陣的快取重同步,確保了大規模特徵與樣本資料下的數值穩定性。 整體架構提供高資料並行度與低記憶體佔用,適用於機器學習中的大規模稀疏模型特徵選擇與路徑求解。編譯時支援開源多執行緒與快速數學浮點優化選項,確保運算效能達到硬體極限。
Connectez-vous à Neumap AI et commencez à créer vos propres mindmaps !
Commencer