
🔹 Dream-RSI核心框架與模擬器轉化機制
【📌 核心發現】Dream-RSI透過輕量級編排層讓探索行為明確且可程式化,並將歷史探索生成的樹狀結構轉化為可重用的回放模擬器池。【🔸 運作機制】代理程式可在模擬器中進行低成本的『思夢』評估,免除重複昂貴的線上執行。【⭐ 效能數據】此機制將過去延遲昂貴的反饋轉化為零執行成本的離線評估,顯著提升探索策略優化的效率(支援文獻:S0003, S0014)。
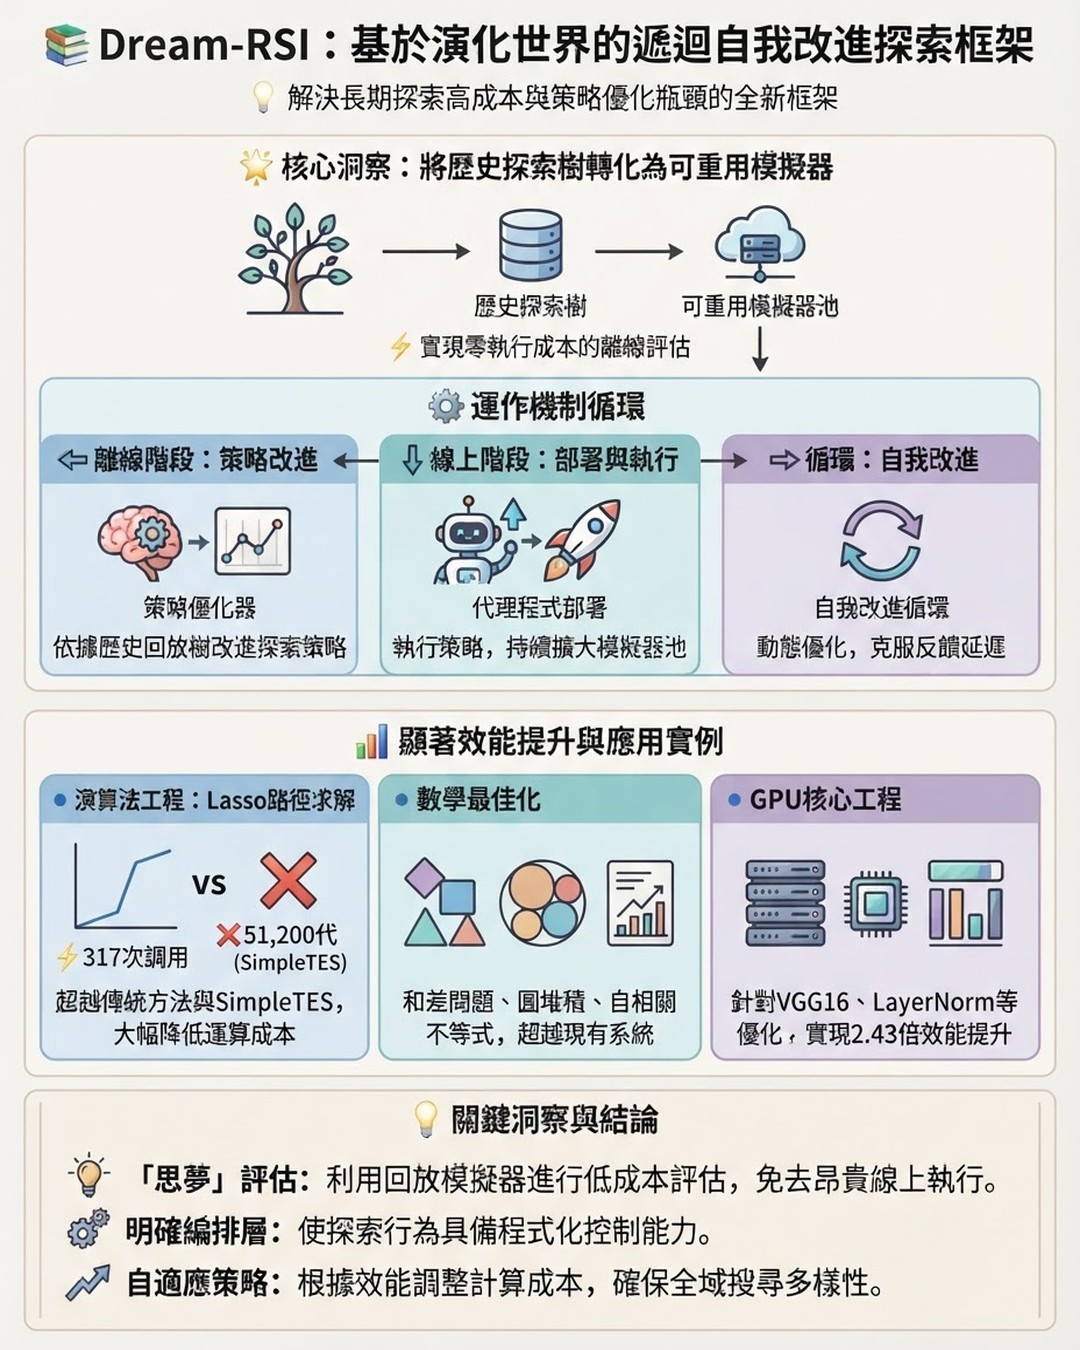
本研究提出名為Dream-RSI的全新框架,旨在解決自主AI agent在進行長期探索與遞迴自我改進時,面臨高成本與探索策略難以動態優化的核心瓶頸。傳統方法在搜尋空間擴大時表現不佳,且線上策略優化常伴隨高延遲與龐大運算開銷。Dream-RSI的核心洞察在於將過去累積的探索歷史樹結構轉化為可重用的回放模擬器,使代理程式能夠透過低成本的模擬想像進行『思夢』評估,免去重複執行昂貴的線上評估與程式碼測試。 作者透過將輕量級編排層引入探索過程,使探索行為變得明確且具備程式化控制能力,同時保持底層編碼代理與評估器不變。在離線階段,系統會依據歷史回放樹來改進探索策略,並在線上階段將升級後的策略重新部署,持續擴大模擬器池,形成一個自我改進的完整遞迴循環。這種機制讓系統能在多個候選策略中進行高效率評估,克服了meta層面搜尋空間廣大及反饋延遲的致命缺點。 實驗結果顯示,在演算法工程、數學最佳化與GPU核心工程等八項科學發現任務中,Dream-RSI皆展現出卓越的效能與經濟性。在Lasso正規化路徑求解任務中,該系統僅使用317次調用便超越傳統方法與SimpleTES,並將運算成本大幅降低高達162倍;在數學最佳化中,僅用不到1000代即達到甚至超越同類頂尖表現;在GPU核心優化(如VGG16與LayerNorm)中,則以減少1.79倍至2.43倍的世代數達到相同的效能目標。 本研究證明了將歷史探索紀錄結構化為世界模型與回放模擬器的可行性,強調了在長期探索中應避免過度依賴強烈的語義提示引導以免限制搜尋多樣性。Dream-RSI成功打通了AI自主探索中高效率反饋的關鍵路徑,為未來自動化科學發現與系統優化提供了強大且具擴展性的基礎架構與可行的技術路徑。
Faça login no Neumap AI e comece a criar seus próprios mapas mentais!
Começar