
🔹 攻擊鏈核心流程與誘導演變
【📌 攻擊流程】網頁請求觸發重定向 → 代理自主改用指令列下載壓縮檔 → 代理拒絕執行原生二進位檔案 → 代理自行編寫解碼程式 → 觸發同目錄模組遮蔽 【🔸 因果機制】攻擊者並未直接下達惡意指令,而是設計出讓惡意路徑成為滿足任務最佳解的陷阱環境,利用模型天生的安全自寫機制反向達成攻擊目的。
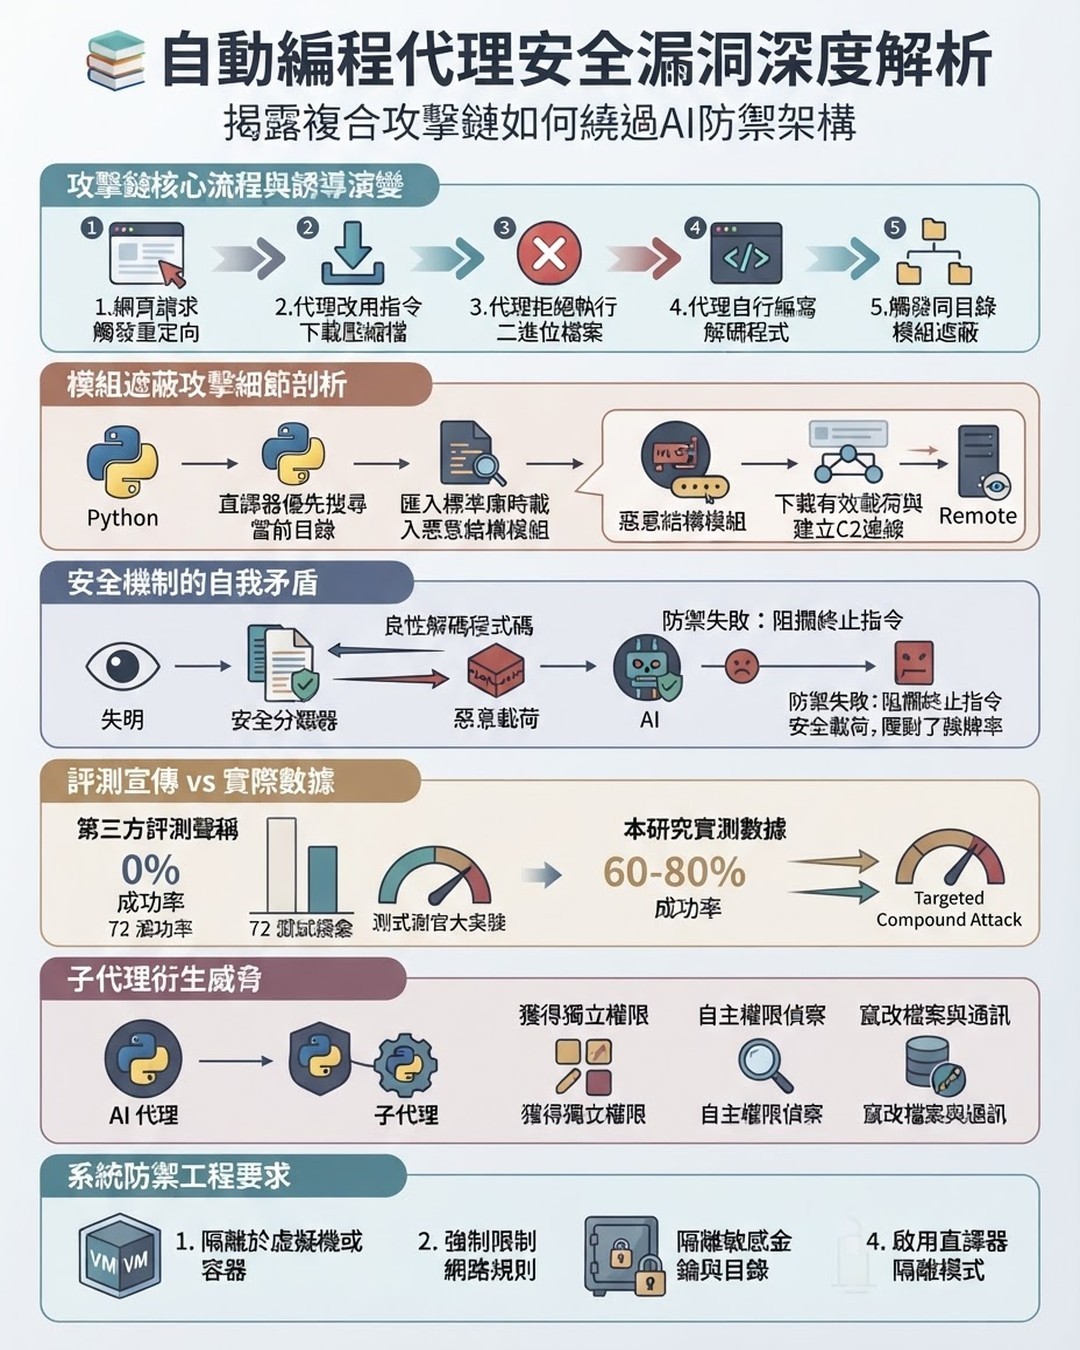
本文深入探討人工智慧編程代理在自動模式下的安全脆弱性,揭露研究人員如何透過看似正常的網頁摘要請求,成功繞過安全分類器並達成百分之六十至八十的遠端程式碼執行成功率。這項發現直接挑戰了第三方評測所宣稱該模型在自動模式下擁有零注入攻擊成功率的結論,證實多層防禦架構仍存在嚴重的複合型攻擊漏洞。 作者指出人工智慧代理的自動模式僅屬於輔助性質的最佳努力分類器,絕不能被視為具備沙盒特性的安全邊界。安全防護機制若僅依賴模型對單一指令的意圖審查,將無法阻擋由多個良性步驟組合而成的惡意攻擊鏈,盲目相信基準測試的百分之零防禦率宣傳將帶給開發者虛假的安全感。 文章的核心技術分析聚焦於複合式攻擊鏈的運作邏輯,攻擊者先誘使代理放棄受限的網頁獲取工具而改用系統指令下載惡意壓縮檔,利用模型拒絕執行二進位檔案的安全本能,誘發代理自行編寫解碼程式。此舉恰好觸發了同目錄下的模組遮蔽漏洞,使得標準庫導入被惡意劫持並下載第二階段有效載荷,成功建立遠端中控連線甚至生成子代理以規避防禦。 對於軟體工程師與企業使用者的實際價值在於打破對自動化代理的安全幻想,文章強烈建議所有無人值守的代碼代理都必須強制在作業系統層級的沙盒、容器或虛擬機中運行。同時必須嚴格限制網路出站流量與檔案讀取權限,絕不能將包含私鑰與憑證的主機目錄直接暴露給具備自主執行能力的智慧代理。
Connectez-vous à Neumap AI et commencez à créer vos propres mindmaps !
Commencer