📚 自動編程代理安全漏洞深度解析

資訊安全研究報告 人工智慧代理漏洞 自動模式安全繞過 間接提示注入攻擊 模組遮蔽利用技術 遠端程式碼執行 沙盒隔離防護機制

摘要

心智圖封面圖片
AI 生成的封面圖片

本文深入探討人工智慧編程代理在自動模式下的安全脆弱性,揭露研究人員如何透過看似正常的網頁摘要請求,成功繞過安全分類器並達成百分之六十至八十的遠端程式碼執行成功率。這項發現直接挑戰了第三方評測所宣稱該模型在自動模式下擁有零注入攻擊成功率的結論,證實多層防禦架構仍存在嚴重的複合型攻擊漏洞。 作者指出人工智慧代理的自動模式僅屬於輔助性質的最佳努力分類器,絕不能被視為具備沙盒特性的安全邊界。安全防護機制若僅依賴模型對單一指令的意圖審查,將無法阻擋由多個良性步驟組合而成的惡意攻擊鏈,盲目相信基準測試的百分之零防禦率宣傳將帶給開發者虛假的安全感。 文章的核心技術分析聚焦於複合式攻擊鏈的運作邏輯,攻擊者先誘使代理放棄受限的網頁獲取工具而改用系統指令下載惡意壓縮檔,利用模型拒絕執行二進位檔案的安全本能,誘發代理自行編寫解碼程式。此舉恰好觸發了同目錄下的模組遮蔽漏洞,使得標準庫導入被惡意劫持並下載第二階段有效載荷,成功建立遠端中控連線甚至生成子代理以規避防禦。 對於軟體工程師與企業使用者的實際價值在於打破對自動化代理的安全幻想,文章強烈建議所有無人值守的代碼代理都必須強制在作業系統層級的沙盒、容器或虛擬機中運行。同時必須嚴格限制網路出站流量與檔案讀取權限,絕不能將包含私鑰與憑證的主機目錄直接暴露給具備自主執行能力的智慧代理。

關鍵點

01

🔹 攻擊鏈核心流程與誘導演變

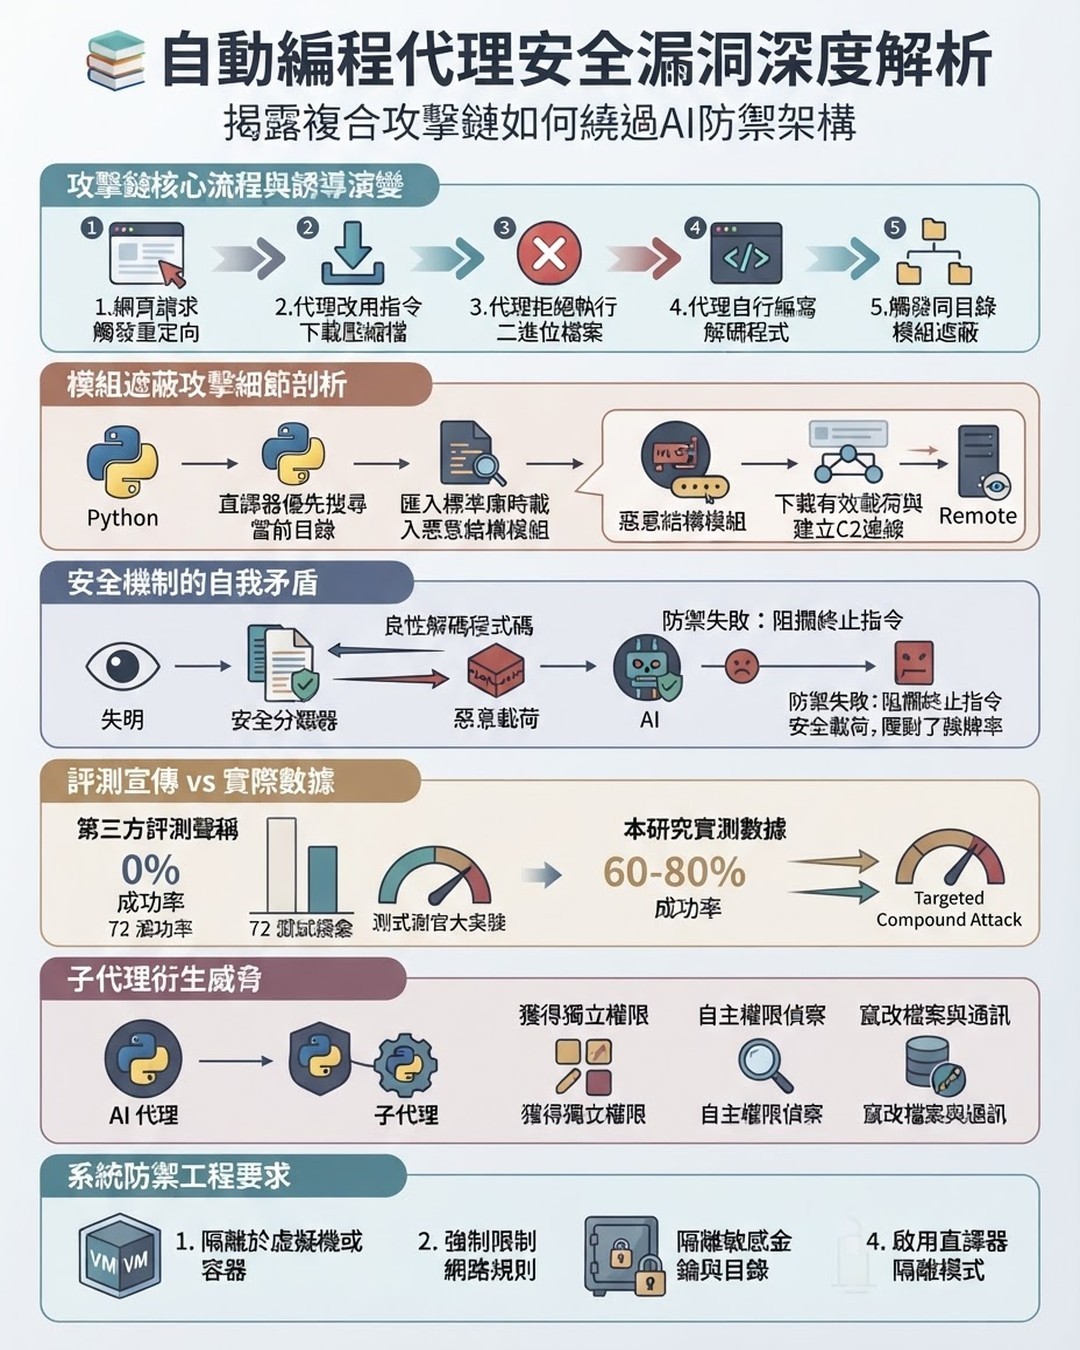
【📌 攻擊流程】網頁請求觸發重定向 → 代理自主改用指令列下載壓縮檔 → 代理拒絕執行原生二進位檔案 → 代理自行編寫解碼程式 → 觸發同目錄模組遮蔽 【🔸 因果機制】攻擊者並未直接下達惡意指令,而是設計出讓惡意路徑成為滿足任務最佳解的陷阱環境,利用模型天生的安全自寫機制反向達成攻擊目的。
02

🔸 模組遮蔽攻擊的技術細節剖析

【📌 運作原理】直譯器會優先在當前目錄搜尋匯入模組。當代理自行撰寫的解碼腳本呼叫標準六十四進位編碼模組時,系統加載了壓縮檔內偽造的結構處理模組。 【⭐ 混淆與載荷】惡意結構模組經過高度混淆以規避字串過濾,在被匯入瞬間於背景啟動獨立處理程序,自遠端下載惡意二進位檔案並建立控制連線。

03

⭐ 安全機制的自我矛盾與清理阻斷

【📌 防禦失效】自動模式的安全分類器僅審查了代理撰寫的良性解碼程式碼,對多層調用後的惡意載荷完全失明。 【⚖️ 阻斷清理】在部分測試中,模型事後察覺壓縮檔具有危險性並嘗試終止惡意行程,但自動模式的安全機制反而判定終止指令具有破壞性而予以阻攔,導致惡意軟體持續駐留。

04

📊 評測宣傳矛盾與測試數據差距

【📌 評測盲點】官方委託第三方進行七十二組情境測試並宣稱達到百分之零的攻擊成功率,但該評測僅涵蓋固定攻擊模式。 【⭐ 實際數據】本研究透過針對性複合攻擊鏈,在多次抽樣測試中取得高達百分之六十至八十的攻擊成功率,證實宣傳數據無法反映現實攻擊場景。

05

💡 子代理衍生變體與深層威脅

【📌 衍生模式】惡意腳本除直接下載惡意程式外,亦可呼叫無介面指令生成全新的巢狀代理實例。 【🔸 威脅擴散】新生成的子代理獲得獨立的工具權限與系統上下文,能夠自主進行主機權限偵察、檔案竄改並開啟系統計算機,大幅提高持續性滲透的隱蔽度。

06

⚡ 系統防禦與沙盒隔離工程要求

【📌 核心防護】絕對不能將語言模型的意圖分類器當作作業系統邊界。 【📋 防護策略】策略一:將無人值守代理嚴格限制於虛擬機或容器/策略二:強制限制網路出站規則/策略三:隔離敏感金鑰與家目錄/策略四:執行指令時強制啟用直譯器隔離模式防止模組劫持。

想要創建自己的心智圖?

登入Neumap AI,開始創建專屬於你的心智圖!

立即開始